FabricをAIのナレッジソースにする——OneLakeのRAGから、利用者に届く仕組みまで
はじめに:OneLakeをRAGにつなぐ記事を読んで
Microsoft Fabricに蓄積したデータを、生成AIからどのように利用できるのか。その接続方法を考えるきっかけになったのが、ヘッドウォータースのせとぅさんによる次の記事でした。
Microsoft Fabric OneLake × Azure AI Search でRAGを構築する
この記事では、NYCのタクシー乗車データをFabricのNotebookで集計し、地域ごとのテキストレポートを作成しています。そのレポートをOneLakeに保存し、Azure AI SearchのOneLake filesインデクサーで検索可能にしたうえで、Azure OpenAIを使って自然言語の質問に回答する構成が紹介されています。
私が面白いと感じたのは、Fabricにあるデータを分析に使うだけでなく、AIが説明するためのナレッジへ変換しているところです。OneLakeに置いたファイルを直接検索基盤へ接続できるため、検索用の別ストレージへファイルを転送する処理も省けます。
構成全体はFabricだけで完結するものではなく、Azure AI Search、Azure OpenAI、Key Vaultも利用します。それでも、データの保管と加工、ナレッジとなるレポートの作成をFabricに置けることは、既存のデータ基盤をAIへつなぐうえで魅力があります。
本稿では、この方式から得た気づきを出発点として、FabricをAIのナレッジソースにするための機能と、それを利用者に届けるまでの構成を整理します。元記事のNYCの例は、接続方式を理解するためのデモとして読み、その方式を業務で活かす場合にどのような機能を組み合わせられるかを考えます。
本サイトの関連記事では、Microsoftの企業データとAI活用の全体像でOneLakeやFabric IQを含む知識基盤全体を、Skills for Fabricの調査まとめでAIコーディングツールにFabricの操作知識を与える方法を扱いました。本稿ではその流れを受け、Fabric上のデータや文書をAIがどう参照し、利用者の接点まで届けるかに焦点を当てます。
本稿の機能・連携に関する記述は、2026年10月7日時点で確認したMicrosoftの公式情報に基づきます。構成図と組み合わせパターンは、機能の役割を整理した設計例です。プレビューの機能・連携は本文で区別しています。
1. データを「説明できるナレッジ」にするRAG
元記事の流れは、次のように捉えられます。
- Lakehouseの構造化データをNotebookで集計する。
- 集計結果を、地域の特徴を説明するテキストレポートにする。
- レポートをOneLakeのFilesに保存する。
- Azure AI Searchでレポートをインデックス化する。
- 質問に関連するレポートを検索し、LLMが回答を作る。
質問のたびに元の大量データを分析するのではなく、分析した結果をナレッジとして用意しておく方式です。大きなデータを、利用者が知りたい特徴を含む小さなレポートへ変換することで、自然言語からアクセスしやすくしています。
この方式の良さと、適用時に考えたいこと
| 観点 | 良さ | 適用時に考えたいこと |
|---|---|---|
| 大量データの扱い | 事前集計によって、質問時に扱う情報を小さくできる | レポートに必要な情報を残す設計が必要 |
| 指標の統一 | 集計コードで計算方法を固定できる | 指標の定義や対象期間も一緒に伝えるとよい |
| 利用しやすさ | SQLを知らない利用者も、自然言語で特徴を確認できる | 追加の切り口や再集計には、別の照会経路があると便利 |
| 基盤との接続 | OneLakeのファイルを直接検索基盤につなげられる | 検索インデックスとAIサービスの運用も必要 |
| 内容の確認 | ナレッジとなるレポートを人が確認できる | データ更新、レポート再生成、検索更新をつなぐ必要がある |
OneLake filesインデクサーは、LakehouseのFilesにある文書を検索可能にする仕組みです。TablesやDelta/Parquetを直接照会するものではないため、この記事ではテキストレポートへの変換が接続の橋渡しになっています。また、更新反映にはインデクサーの実行が必要です。継続利用では、レポート生成とインデックス更新のスケジュールを設計します。[1]
この方式は、データから伝えたい事実や切り口がある程度決まっている場合に、特に使いやすいと思います。例えば、店舗の月次サマリー、設備の稼働レポート、地域ごとの需要の特徴などです。
重要なのは、あらゆる質問文を予想することよりも、どの指標と切り口を説明できるようにするかを決めることです。同じ情報がレポートにあれば、利用者のさまざまな言い回しに対応できます。
2. 例を読み解くと、補完する機能が見えてくる
NYCの例を通じて理解できたのは、自然言語の質問でも、必要な処理は一様ではないということです。
「この地域にはどのような特徴があるか」という質問なら、地域別のレポートを検索して説明する構成がよく合います。一方、「全地域で最も高い指標は何か」「曜日別に比較したい」という質問では、全体の数値比較や追加集計を組み合わせると、回答できる範囲を広げられます。
さらに、「その指標が業務上何を意味するか」には、指標の定義が必要です。「この結果を受けて、どの対応を取るか」には、業務ルールや手順書も役立ちます。
| 利用者が知りたいこと | 組み合わせたい仕組み |
|---|---|
| 対象の特徴や背景 | レポート・文書の検索 |
| 順位、期間比較、条件に合う対象 | データへのクエリ・集計 |
| 売上や粗利率などの指標の意味 | セマンティックモデルによる定義 |
| 顧客・注文・配送などの関係 | 業務概念と関係のモデル化 |
| 確認後の申請、通知、登録 | ワークフローや業務API |
これはデモを業務分析システムとして評価するというより、紹介された方式を理解することで、他の機能とどう組み合わせられるかに気づいた、という整理です。レポートによるRAGは、分析結果を利用者へ届ける一つの有効な経路です。その経路にデータ照会や業務上の意味を補う仕組みを足すことで、用途を広げられます。
3. FabricをAIのナレッジソースにする機能
Fabric側の機能は、「データを整える」「意味を与える」「AIから利用する」という役割で見ると理解しやすくなります。
OneLakeとデータ整備:共通の土台を作る
OneLakeは、Fabricの各機能が利用する共通のデータ基盤です。Lakehouse、Warehouse、Eventhouseなどを利用し、Data FactoryやNotebookでデータを取り込み、加工できます。ShortcutsやMirroringも、データを統合して利用するための選択肢です。[2]
これらは、それだけで自然言語の回答を作る機能ではありません。しかし、AIの根拠となるデータを整備し、更新し続ける土台です。元記事のNotebookも、この土台の上でレポートを作る役割を担っています。
OneLake filesインデクサー:文書として提供する
Azure AI SearchのOneLake filesインデクサーを使うと、OneLakeにある文書を検索対象にできます。分析レポートだけでなく、手順書や説明資料などをAIの回答根拠として利用する経路です。[1]
検索用のファイル転送処理を省ける一方、Azure AI Search側には検索インデックスが作られます。OneLakeのファイルを直接読んで、その都度すべてを分析する構成とは異なります。
Fabric Data Agent:質問時にデータを照会する
Fabric Data Agentは、自然言語の質問に応じてクエリを生成・検証・実行し、結果を回答する機能です。事前にまとめたレポートを検索する方式と比べると、その場の問いに必要な集計を行う点に特徴があります。[3]
| 主なデータソース | 照会方法 | 活用例 |
|---|---|---|
| Lakehouse、Warehouseなど | SQL | 条件抽出、順位、期間比較 |
| EventhouseのKQL Database | KQL | ログ、イベント、時系列の分析 |
| Power BIセマンティックモデル | DAX | 定義済みのKPIを用いた分析 |
| Graph〔プレビュー〕 | GQL | 関係や依存の探索 |
| Azure AI Search〔プレビュー〕 | 文書検索 | 文書を根拠にした回答 |
Data Agentは、複数のデータソースを利用できます。現在のデータソース一覧にはAzure AI Searchも含まれており、データ照会と文書検索を組み合わせる選択肢も用意されています。[4]
ただし、Data Agentを使えばデータ理解が不要になるわけではありません。対象のテーブル、用語、結合の考え方、集計条件などを整備し、説明や指示、クエリ例を与えることが重要です。事前レポートの設計に代わって、データを正しく照会するための設計が必要になります。
また、Data Agentは読み取りを担う機能です。データ更新や業務処理は、上位のワークフローなどに役割を分けます。[3]
セマンティックモデル:信頼できる指標を共有する
Power BIセマンティックモデルでは、メジャー、ディメンション、関係、階層などを定義できます。例えば、「売上」「粗利率」「前年同期比」の計算を共有し、レポートとAIが同じ指標を使う土台にできます。[2][4]
さらに、Prep data for AIでは、AI向けのデータスキーマ、指示、Verified Answersを整備できます。データを保存するだけでなく、AIが業務に沿って解釈しやすい形にするための機能です。[5]
Fabric IQとOntology:業務の言葉でデータを理解する
Fabric IQは、OneLakeのデータに業務上の意味を与え、人やAIが共通の言葉で利用するための仕組みです。セマンティックモデルに加えて、Ontology〔プレビュー〕で顧客、注文、配送、設備などの概念、属性、関係と実データの対応を定義できます。[2]
セマンティックモデルが信頼できる指標を提供し、Ontologyが業務概念や関係を補う、と考えると役割が分かりやすくなります。Data Agentも、Ontologyを質問の解釈に利用できます。[4]
MCPとFoundry IQ:外部のAIにつなぐ
公開したData Agentは、MCPツールとして上位のAIから利用できます。上位側が自然言語の質問を渡し、Data Agentが分析した結果を受け取る構成です。[6]
また、Foundry IQを支えるAzure AI Searchのナレッジソースには、OneLakeをインデックス化する経路と、Data Agentへ質問時に照会するリモート経路〔プレビュー〕があります。文書とデータ分析を、共通のナレッジ取得の仕組みに組み込む選択肢です。[7]
ここでは、Fabric IQは業務データの意味を提供する側、Foundry IQは複数のナレッジを取得してAIへ届ける側、と捉えると整理しやすいと思います。
4. ナレッジソースから、利用者が使えるところまで
FabricのデータをAIから利用できるようにしても、それだけで利用者の業務画面が完成するわけではありません。利用者との接点と、必要な情報源・機能を使い分ける統合層を考える必要があります。
| 層 | 役割 | 主なサービス・機能 |
|---|---|---|
| 利用者との接点 | 質問、結果の閲覧、業務操作 | Microsoft 365 Copilot、Teams、Power BI、独自Webアプリ |
| 機能の統合・実行 | 情報源の選択、回答の統合、業務処理 | Copilot Studio、Foundry Agent Service、Agent Framework、Power Automate |
| ナレッジの提供 | 文書検索、データ照会、業務上の意味の提供 | Azure AI Search/Foundry IQ、Data Agent、セマンティックモデル、Ontology |
| データの基盤 | データの統合、保存、加工、更新 | OneLake、Lakehouse、Warehouse、Eventhouse、Data Factory、Notebook |
製品を厳密に一つの層へ分類するための表ではなく、設計上の役割を分けるための表です。Data Agentは直接対話する入口にもなりますし、上位エージェントから呼び出す分析機能にもなります。
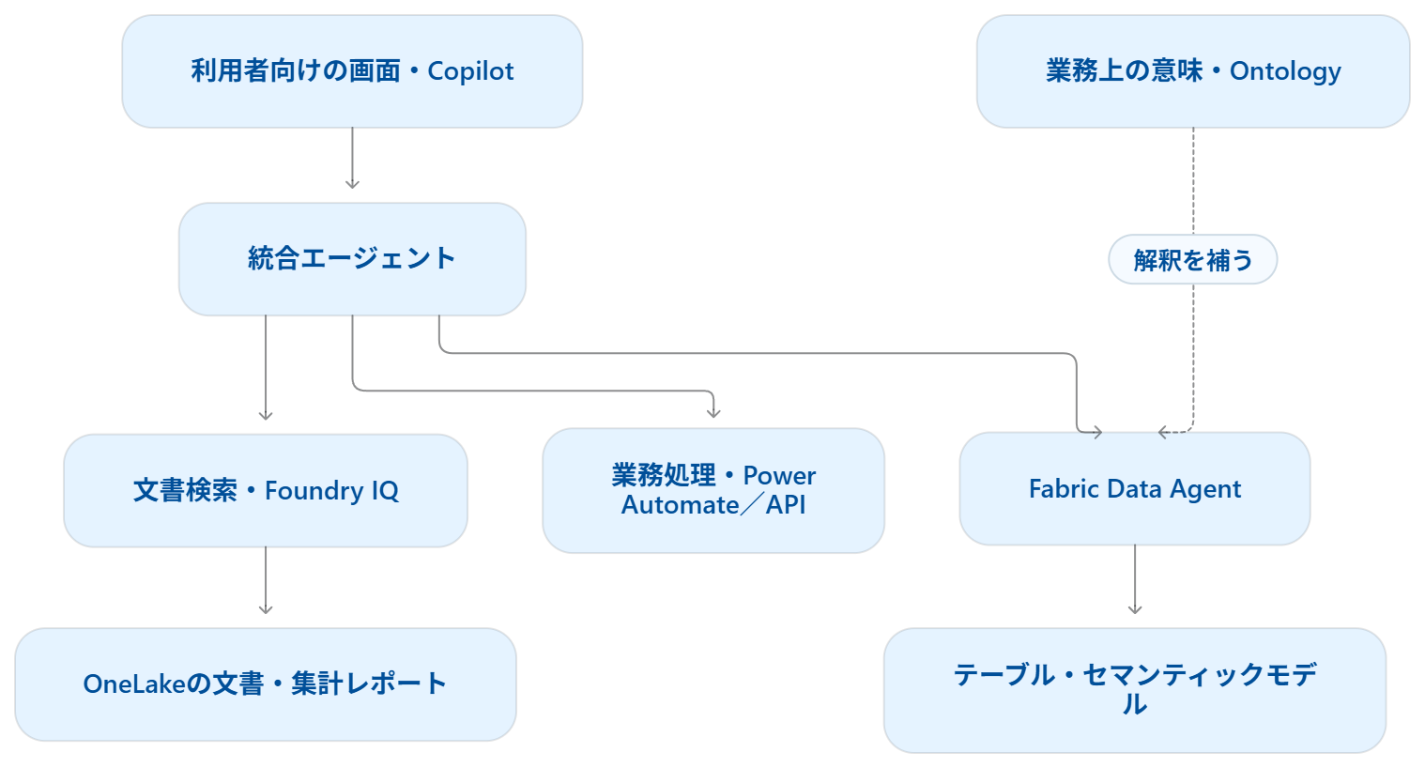
図1:Fabricのナレッジを利用者へ届けるための役割分担。文書検索とデータ照会を並行して利用する概念図であり、全機能を必須とする構成ではありません。
Microsoftサービスとの組み合わせパターン
| パターン | 利用者との接点 | 統合の中心 | 主なナレッジ経路 | 適した用途 |
|---|---|---|---|---|
| 分析画面から利用 | Power BI | Power BIのCopilot | セマンティックモデル | KPIの理解、レポートの説明 |
| 日常のCopilotから利用 | Microsoft 365 Copilot/Teams | Microsoft 365 Copilot | 公開したData Agent | 社員による業務データへの質問 |
| 業務処理につなぐ | Teamsなど | Copilot Studio+Power Automate | Data Agent、文書ナレッジ | 確認から通知・申請へつなぐ |
| 複数の情報源を統合 | 独自Webアプリ、Teamsなど | Foundry Agent Service | Data Agent/Fabric IQ、文書検索 | 数値と文書、外部APIを合わせた回答 |
| ナレッジ取得を共通化 | 上位エージェントの各画面 | 上位エージェント+Foundry IQ | OneLake文書、リモートData Agent | 複数エージェントで情報取得を共有 |
| 処理をコードで制御 | 独自アプリ、Teams | Agent Framework+独自API | MCP、固定クエリなど | 独自の処理手順や品質管理 |
例えば、分析結果をPower BI上で理解したいなら、セマンティックモデルとCopilotを中心に考えられます。普段の業務の中からデータへ質問したいなら、Data AgentをMicrosoft 365 Copilotへ公開する経路が候補になります。この公開連携はプレビューです。[5][8]
データを確認した後に申請や通知を行いたいなら、Copilot StudioとPower Automateなどを上位に置きます。Data Agentは読み取りと分析を担当し、業務処理は別のツールが担当する形です。Copilot Studioには接続エージェント方式とMCPを利用するツール方式があるため、採用する方式と公開先チャネルを合わせて確認します。[9]
より自由な統合が必要なら、Foundry Agent ServiceからData Agentや文書検索を呼び出す構成が考えられます。Fabric IQを通じてData Agent、Ontology、セマンティックモデルに接続する経路も用意されていますが、この連携はプレビューです。[10]
処理順序や計算をコードで制御したい場合は、Agent Frameworkと独自APIを組み合わせられます。Teamsなどのチャネルへ届ける部分にはMicrosoft 365 Agents SDKを利用できます。同SDKは会話やチャネル接続を担い、推論やオーケストレーションは別のAIサービスやフレームワークと組み合わせます。[11]
例:実績を確認し、対応案を考える
「売上が落ちている店舗を確認して、対応案を考えたい」という問いなら、次の役割分担が考えられます。
- Data Agentが、売上や前年同期比などの実績を確認する。
- 文書検索が、過去の施策や運用ルールを取得する。
- 上位エージェントが、数値と文書の根拠を合わせて対応案を作る。
- 利用者の判断を受けて、ワークフローが申請や通知を行う。
ここでは、数値の変化、原因に関する仮説、実行する対応を分けて扱います。それぞれに適した機能を使うことで、レポート検索から始まった仕組みを、利用者の判断や行動につなげられます。
なお、上位の画面から利用できるようにしても、元データへの権限が不要になるわけではありません。Data Agentを外部から利用する経路では、利用者本人の権限で照会する構成があり、エージェントとデータソースの両方へのアクセスが必要です。認証と権限は、採用する接続方式に合わせて設計します。[8][10]
おわりに
元記事を読んで知ったのは、Fabricにあるデータをレポートへ変換し、OneLakeからRAGのナレッジへつなぐ具体的な経路でした。データを理解してまとめておくことで、自然言語から分析結果へアクセスしやすくなる点に価値があります。
そこから考察を広げると、文書として説明する経路に加えて、Data Agentによる質問時の照会、セマンティックモデルによる指標の共有、Ontologyによる業務概念の整理という選択肢が見えてきます。
利用者に届ける際は、何を知りたいのか、どこから使いたいのか、確認後にどの業務へつなげたいのかを起点に、必要な機能を組み合わせるのがよさそうです。定型的な説明にはレポートのRAGを使い、追加集計にはData Agentを使う。共通の指標や業務用語を整え、その上に利用者との接点を置く。その役割分担が、FabricをAIのナレッジソースとして活かすための設計につながると考えています。
参考資料
- 元記事:Microsoft Fabric OneLake × Azure AI Search でRAGを構築する
- [1] OneLake filesインデクサー
- [2] What is Fabric IQ?
- [3] Fabric data agent concepts
- [4] Data Agentで利用できるデータソースと設定
- [5] Power BI:Prep data for AI
- [6] Data AgentのMCPサーバー
- [7] Azure AI Searchのナレッジソース、Fabric Data Agentナレッジソース〔プレビュー〕
- [8] Microsoft 365 CopilotからData Agentを利用する〔プレビュー〕
- [9] Copilot StudioでData Agentをツールとして利用する、接続エージェント方式〔プレビュー〕
- [10] FoundryからData Agentを利用する、FoundryからFabric IQへ接続する〔プレビュー〕
- [11] Microsoft Agent Framework、Microsoft 365 Agents SDK