Microsoftにみる企業データとAI活用の全体像
企業の情報は「どこで発生し、どこに永続化され、どう統合され、どうAIに届くか」の一本の流れで捉えると、Microsoftのサービス群はほぼすべて位置づけられます。M365で発生する非構造データは SharePoint 系ストレージ(SharePoint・OneDrive・SharePoint Embedded)と Exchange に集まり、M365の外で発生する構造化データは Fabric の OneLake に集まります。その上に、2025年以降 Microsoft が「IQ」と呼ぶ知識レイヤー(Work IQ・Fabric IQ・Foundry IQ・Web IQ)が重なり、Copilot や Foundry で作るエージェントが共通の文脈として使う、という構図です。
このドキュメントは、各サービスを知らない人でも読めるよう、用語集と図を交えてこの流れを順に説明します。最後に、いただいた考えの一つ一つについて正誤と補足をまとめています。
## 全体像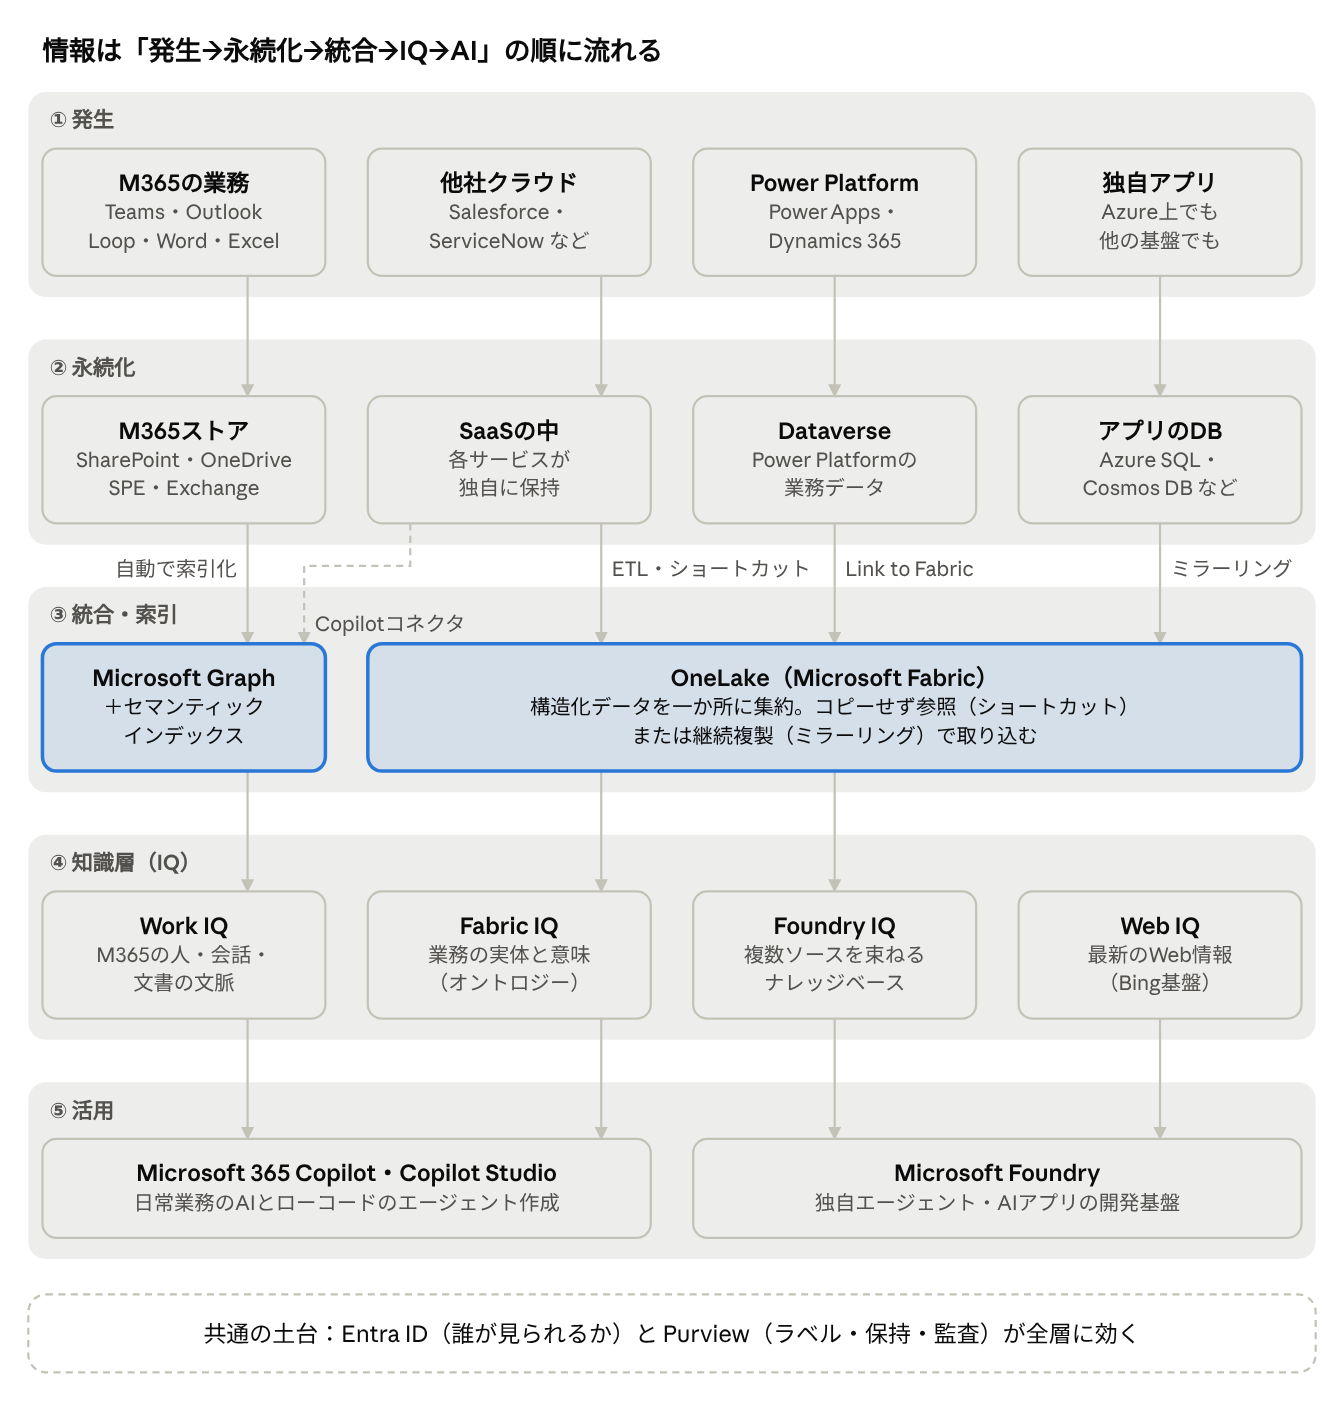
上から下へ、①情報が生まれ→②保存され→③二つの集約点(色付きの Microsoft Graph と OneLake)に集まり→④ IQ がビジネスの文脈を与え→⑤ AI に届く、と読みます。点線は他社 SaaS のデータを Copilot コネクタで M365 側に取り込む経路です。④→⑤の矢印は代表的な組み合わせで、実際にはどの IQ も Copilot と Foundry の両方から使えます。
用語集
本文に出てくる言葉を、図の層の順に並べました。
| 用語 | 層 | ひとことで言うと |
|---|---|---|
| 非構造データ | — | 文書・スライド・メール・動画など、表の形になっていないデータ。対になるのが、行と列で整理された「構造化データ」(受注表、顧客マスタなど) |
| Microsoft 365(M365) | ① | Teams・Outlook・Word・Excel など、日常業務で使うクラウドサービスの総称 |
| Teams | ① | チャット・会議・ファイル共有をまとめたコミュニケーション基盤 |
| Loop | ① | 複数人で同時に書き込める共同編集ノート。TeamsやOutlookの中に「部品(コンポーネント)」として埋め込める |
| Power Platform | ① | ローコードで業務アプリ(Power Apps)、自動化(Power Automate)、分析(Power BI)を作る製品群 |
| Dynamics 365 | ① | 営業・サービス・会計などの業務アプリ(CRM/ERP)。データは Dataverse に入る |
| SharePoint | ② | 組織のファイルとサイトを持つ文書管理基盤。M365 の非構造データの中心 |
| OneDrive | ② | 個人用のファイル置き場。中身は SharePoint と同じ技術で動いている |
| SharePoint Embedded(SPE) | ② | 画面を持たない SharePoint の「保存容器」。Loop のワークスペースなど、アプリ専用の文書を持つ |
| Exchange | ② | メールと予定表の保存先。Teams のチャット本文もここに保存される |
| Dataverse | ② | Power Platform と Dynamics 365 が使うデータベース(構造化データの置き場) |
| Azure | ② | Microsoft のクラウド基盤。独自アプリやそのデータベース(Azure SQL、Cosmos DB など)を動かす |
| Microsoft Graph | ③ | M365 の人・メール・ファイル・会議をつなぐ共通の窓口(API)。「誰が何に関わったか」の関係も持つ |
| セマンティックインデックス | ③ | 文書の「意味」で検索できるようにする索引。文章を数値の列(ベクトル)に変えて保持し、Microsoft が自動で作成する |
| ベクトル(埋め込み) | ③ | 文章の意味を表す数値の列。意味が近い文章ほど数値も近くなるので、言い回しが違っても見つかる |
| Copilot コネクタ | ③ | 他社サービスのデータを Microsoft Graph に取り込み、Copilot から検索できるようにする仕組み(旧称 Graph コネクタ) |
| Microsoft Fabric | ③ | データの取り込み・加工・分析・可視化を一つにまとめたデータ基盤 |
| OneLake | ③ | Fabric の中心にある「組織に一つだけのデータの湖」。構造化データの集約点 |
| ショートカット / ミラーリング | ③ | OneLake にデータを集める方法。前者はコピーせず参照し、後者は元の DB を継続的に複製する |
| ETL / Data Factory | ③ | データを抽出(Extract)・変換(Transform)・格納(Load)する処理。Data Factory は Fabric の ETL 機能 |
| IQ(Microsoft IQ) | ④ | エージェントに企業の文脈を渡す知識層の総称。Work IQ・Fabric IQ・Foundry IQ・Web IQ からなる |
| オントロジー | ④ | 「顧客」「注文」「出荷」のような業務上の実体と、その関係・ルールを定義した辞書 |
| RAG | ④ | AI が答える前に社内文書を検索し、その内容を根拠に回答させる手法(検索拡張生成) |
| エージェント | ⑤ | 指示を受けて自分で調べ、判断し、ツールを使って仕事を進める AI |
| Microsoft 365 Copilot | ⑤ | M365 の中で動く AI アシスタント。ユーザーが見られる情報だけを使って答える |
| Copilot Studio | ⑤ | ローコードでエージェントを作るツール |
| Microsoft Foundry | ⑤ | 開発者がモデルを選び、独自のエージェントや AI アプリを作る Azure の開発基盤(旧 Azure AI Foundry) |
| MCP | ⑤ | AI と外部のデータ・ツールをつなぐ標準の接続方式(Model Context Protocol) |
| Entra ID / Purview | 土台 | Entra ID は「誰が何にアクセスできるか」を管理する ID 基盤。Purview は機密ラベル・保持・監査などデータの管理を担う |
M365 の非構造データ基盤:SharePoint を中心に集約される
M365 を使っている企業では、日々の文書・会議・共同作業から生まれる非構造データのほとんどが SharePoint 系のストレージに自動で集まります。利用者が「どこに保存するか」を意識しなくても、どこで作ったかで保存先が決まるのが特徴です。
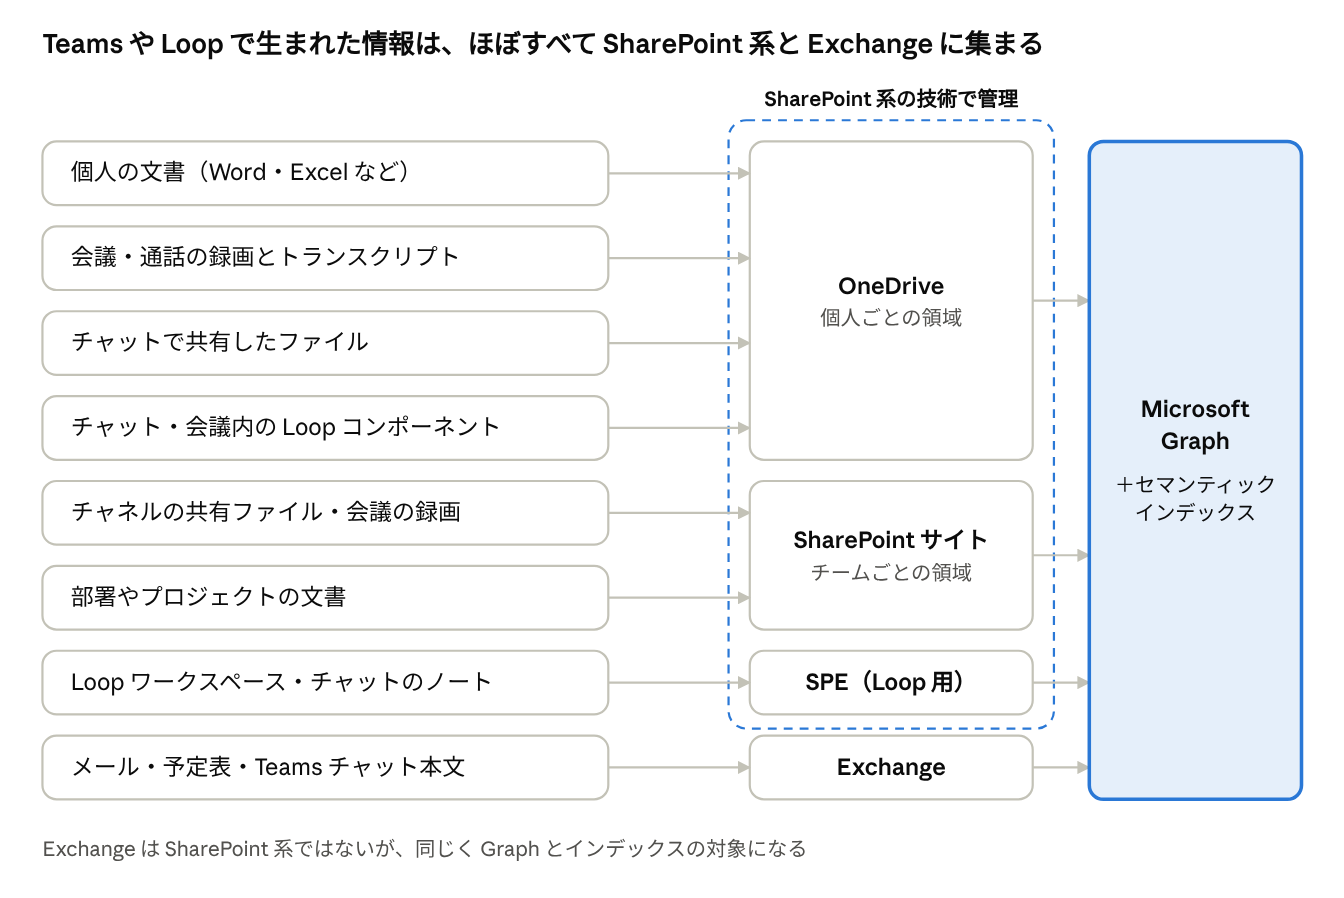
- SharePoint が中心:チームや部署の文書、Teams のチャネルで共有したファイルやチャネル会議の録画は、そのチームの SharePoint サイトに入ります。
- OneDrive も同じ技術:OneDrive は SharePoint と同じ基盤の個人用領域です。通常の会議の録画とトランスクリプトは主催者の OneDrive の Recordings フォルダーに、チャットで共有したファイルは送った人の OneDrive に保存されます(録画の保存先)。
- Loop は作った場所で決まる:Loop アプリのワークスペースは SharePoint Embedded(SPE)のコンテナーに、Teams のチャットや Outlook で作った Loop コンポーネントは作成者の OneDrive に、チャネルで作ったものは SharePoint サイトに入ります(Loop の保存先)。どれも SharePoint の容量と権限管理の内側です。
- Exchange を忘れない:メールと予定表、そして Teams のチャット本文は SharePoint ではなく Exchange に保存されます。非構造データのもう一つの柱です。
- ベクトルの索引は自動:Copilot 向けのセマンティックインデックスは、テナント(組織)単位では SharePoint のテキスト文書から、ユーザー単位ではメールボックスや関わった文書から作られます。管理者の設定なしに Microsoft が自動で有効にします(セマンティックインデックス)。
ここから言えるのは、M365 の中では「データを集める」作業がほぼ不要だということです。代わりに重要になるのは権限の設計です。Copilot は利用者が見られるものだけを使うため、共有設定が甘いサイトはそのまま AI 経由の情報漏えにつながります。
M365 の外で生まれるデータ:OneLake に集める
M365 の外で発生するデータは大きく 3 つで、どれも主な集約先は Microsoft Fabric の OneLake です。こちらは M365 と違い自動では集まらないため、どの経路でつなぐかを意図して選ぶ必要があります。
| 発生源 | データの置き場 | Fabric(OneLake)への経路 | M365・Copilot 側への経路 |
|---|---|---|---|
| 独自に開発したアプリ | Azure SQL、Cosmos DB、PostgreSQL、他社クラウドの DB など | ミラーリング(最短 15 秒間隔で継続複製)、ショートカット、Data Factory | カスタムの Copilot コネクタ、MCP サーバー |
| Power Platform / Dynamics 365 | Dataverse | Link to Microsoft Fabric(ETL なしで OneLake から参照。更新も自動反映) | Copilot Studio のナレッジとして直接利用、Power Automate で SharePoint へ出力 |
| Microsoft 以外のクラウドサービス | Salesforce、ServiceNow、Snowflake、Google BigQuery、Amazon S3 など | ミラーリング(Snowflake・BigQuery など)、ショートカット(S3 など)、Data Factory | Copilot コネクタ(100 以上の既製品)、Power Platform のコネクタ |
経路は大きく 2 種類あります。データをコピーして集める方法(ミラーリング、ETL、同期型の Copilot コネクタ)と、元の場所に置いたまま参照する方法(ショートカット、Link to Fabric、MCP を使うフェデレーション型コネクタ)です。最近は後者が増えており、「物理的に一か所に集める」より「論理的に一か所から見える」ことが統合の意味になりつつあります。
Dataverse のデータを SharePoint に出力する方法も可能ですが、表形式のデータを文書として切り出すため、集計や最新性が失われます。報告書や契約書のような「文書として残すべきもの」に限るのが現実的です。
AI への接続:3 つの入口から同じデータ資産を使う
データが Graph と OneLake に集まっていれば、AI の入口がどれでも同じ資産を根拠にできます。入口の違いは「誰が作り、どこまで自由に作り込むか」です。
| 入口 | 作る人 | 主に使うデータ | 向いている用途 |
|---|---|---|---|
| Microsoft 365 Copilot | 作らない(最初からある) | Graph とセマンティックインデックス、Copilot コネクタで取り込んだ外部データ | メール要約、会議の振り返り、文書作成など日常業務 |
| Copilot Studio | 業務部門・市民開発者 | SharePoint、Dataverse、Fabric のデータエージェント、コネクタ | 社内ヘルプデスク、申請対応など定型業務のエージェント |
| Microsoft Foundry | 開発者 | Foundry IQ のナレッジベース(SharePoint、OneLake、Blob、Web など)、Work IQ、Fabric IQ | 自社製品への組み込み、複数エージェントの連携など高度な用途 |
どの入口でも共通するのは、利用者の Entra ID で検索し、元データの権限と Purview の機密ラベルがそのまま効くことです。永続化の段階で正しく権限を付けておけば、AI 側で改めて制御する必要が減ります。逆に、これまでは「誰も探し当てないので問題にならなかった」過剰な共有が、AI によって見つかりやすくなります。
IQ:データの上に「意味」の層を重ねる
IQ(Microsoft IQ)は、集めたデータをエージェントがそのまま使える「文脈」に変える知識レイヤーです。これまでエージェントごとに個別に作っていた検索の仕組み(RAG)や用語の定義を、共通の基盤として提供するものと考えると分かりやすいです。
| IQ | 何を知っているか | 元になるデータ | 状況(2026年9月時点) |
|---|---|---|---|
| Work IQ | 誰が誰と何をしているか。人・会議・文書・チャットのつながり | M365(メール、予定、ファイル、チャット、サイト)、Dynamics 365、Power Platform | API は 2026年6月16日に一般提供。REST・MCP・A2A・CLI で利用でき、Copilot ライセンスとは別の従量課金 |
| Fabric IQ | ビジネスが今どうなっているか。「顧客」「注文」などの実体、関係、KPI | OneLake、Power BI のセマンティックモデル、オントロジー | セマンティックモデルとデータエージェントは一般提供、オントロジーとグラフはプレビュー |
| Foundry IQ | 複数の知識源を束ねて、質問に合う根拠を引用付きで返す方法 | SharePoint、OneLake、Azure Blob、Web、MCP など。基盤は Azure AI Search | 一部機能は一般提供、一部はプレビュー |
| Web IQ | 社外の最新情報 | Bing の検索基盤 | Build 2026 で発表、限定プレビュー |
関係を一言で言うと、Work IQ と Fabric IQ が「何を知っているか」、Foundry IQ が「どう取り出すか」を担うという分担です。先の図の 2 つの集約点に対応させると、Graph の上に Work IQ、OneLake の上に Fabric IQ が乗り、Foundry IQ が両方を横断して渡す形です。
特に重要なのは Fabric IQ のオントロジーです。例えば「解約率」の定義が部署ごとに違うと、エージェントは推測で答えるしかありません。業務の言葉を一度定義しておけば、すべてのエージェントが同じ意味で数字を扱えます。
知識の 6 つの層:AI はどこまで「分かって」いるのか
前の章で「意味の層」と呼んだものは、企業の知識を積み上げる 6 つの層のうちの一つです。それぞれの層は異なる問いに答え、AI が把握できる層が増えるほど、AI は「資料を探す道具」から「業務を理解して動く同僚」に近づきます。
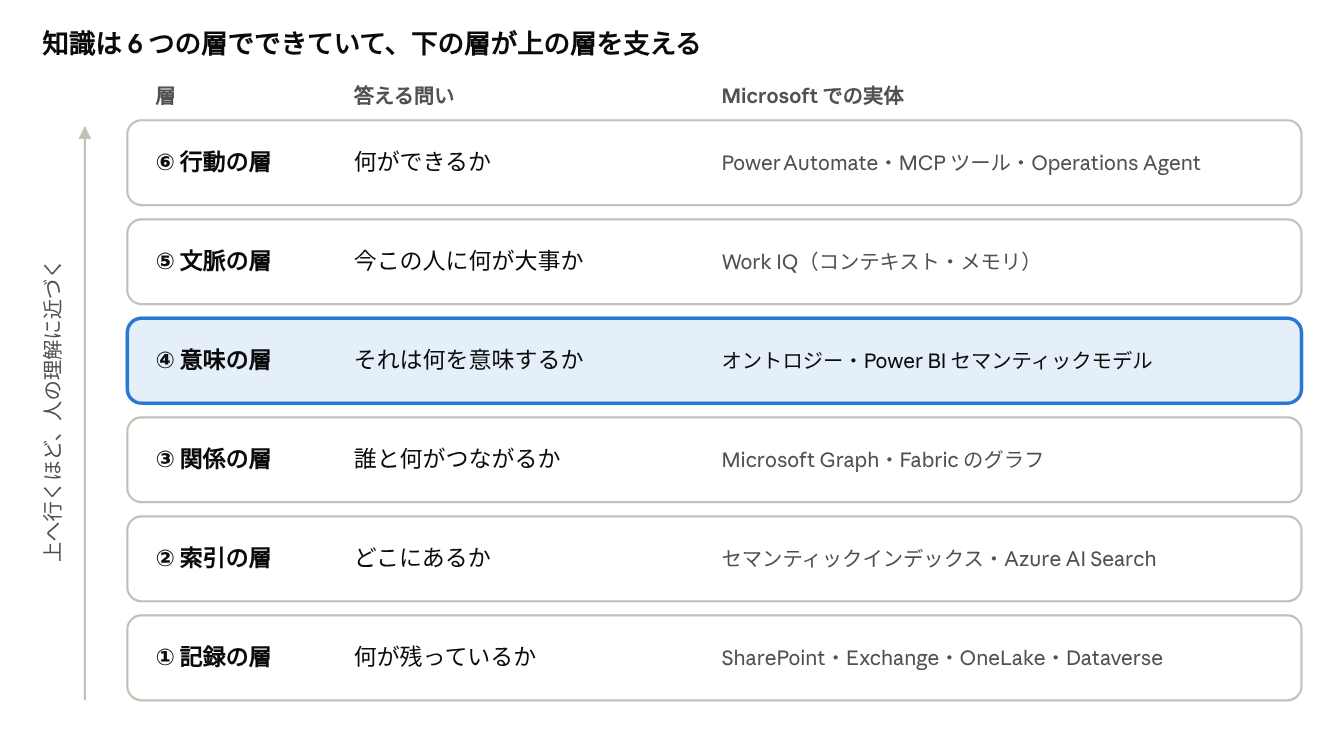
各層の言い換え
- ① 記録の層:文書、メール、会議の録画、表の行といった生のデータそのもの。このドキュメントの「永続化」はこの層を作る作業です。
- ② 索引の層:記録を「探せる」形にしたもの。ベクトルによる意味検索もここに入ります。
- ③ 関係の層:「この資料は誰が作り、どの会議で使われ、どの顧客に関係するか」というつながり。Microsoft Graph が人と文書と会議の関係を持ちます。
- ④ 意味の層:「顧客」「解約率」「今期」が自社で何を指すかという定義。同じ数字を誰が見ても同じように解釈できるようにします。
- ⑤ 文脈の層:「今この人がどの仕事をしていて、何が優先か」。同じ質問でも、誰がいつ聞いたかで正しい答えが変わります。
- ⑥ 行動の層:知ったことをもとに、メールを送る、申請を出す、チケットを起票するといった操作を実行する手段。
層どうしの関係
- 下の層が上の層の上限を決める:記録にないものは探せず、関係が切れていれば意味もつけられません。AI の答えの質は、一番弱い層に引っ張られます。
- 下は自動化、上は設計が必要:①〜③は M365 を使うだけでほぼ自動でできあがります。④の意味と⑥の行動は、企業自身が定義しないと生まれません。
- 非構造と構造化は③④で合流する:①②では別々に保管された文書と数字が、「同じ顧客」「同じ案件」として結びつくのが関係と意味の層です。Work IQ と Fabric IQ が出会う場所とも言えます。
- 権限は全層を貫く:どの層でも「この人に見せてよいか」が先に判定されます。上の層ほど多くの情報を束ねるため、権限の誤りの影響も大きくなります。
複数の層を把握すると、AI に何ができるか
例として、営業担当が「主要顧客 A 社について、次の打ち合わせまでに何をすべき?」と聞いた場合を考えます。
| AI が把握している層 | AI にできること | A 社の例での答え |
|---|---|---|
| ①② 記録・索引 | 資料を探して要約する | A 社が出てくる文書とメールの要約 |
| +③ 関係 | 関係者と経緯をたどる | A 社との直近の会議、そこでの約束、関わった社内の人 |
| +④ 意味 | 数字を自社の定義で解釈する | 「A 社の今期売上は前年比で減少し、解約リスクの基準に該当する」という判断 |
| +⑤ 文脈 | 問う前に優先度を決める | 明日の打ち合わせに向け、この担当者が今日やるべき 3 つのことを提示 |
| +⑥ 行動 | 提案ではなく実行まで行う | 資料の下書きを作り、上司への相談を予定に入れ、フォローのタスクを登録 |
上の行へ進むほど、人が間に入ってつなぐ作業が減ります。①②だけの AI は「質問に答える」だけですが、①〜⑥を把握した AI は「仕事を先回りして進める」ことができます。
このドキュメントの前半(永続化と統合)は①〜③を漏れなく整える話、IQ は③〜⑤を共通基盤にする話です。どちらが欠けても、AI は上の層まで届きません。
これからの企業情報の全体像
今後の企業情報は、「アプリごとに閉じたデータ」から「全エージェントが共有する一つの知識層」へ移っていくと考えられます。データの保存場所は分かれたままでも、IQ を通して同じ意味と同じ権限で見える状態が、統合の到達点です。
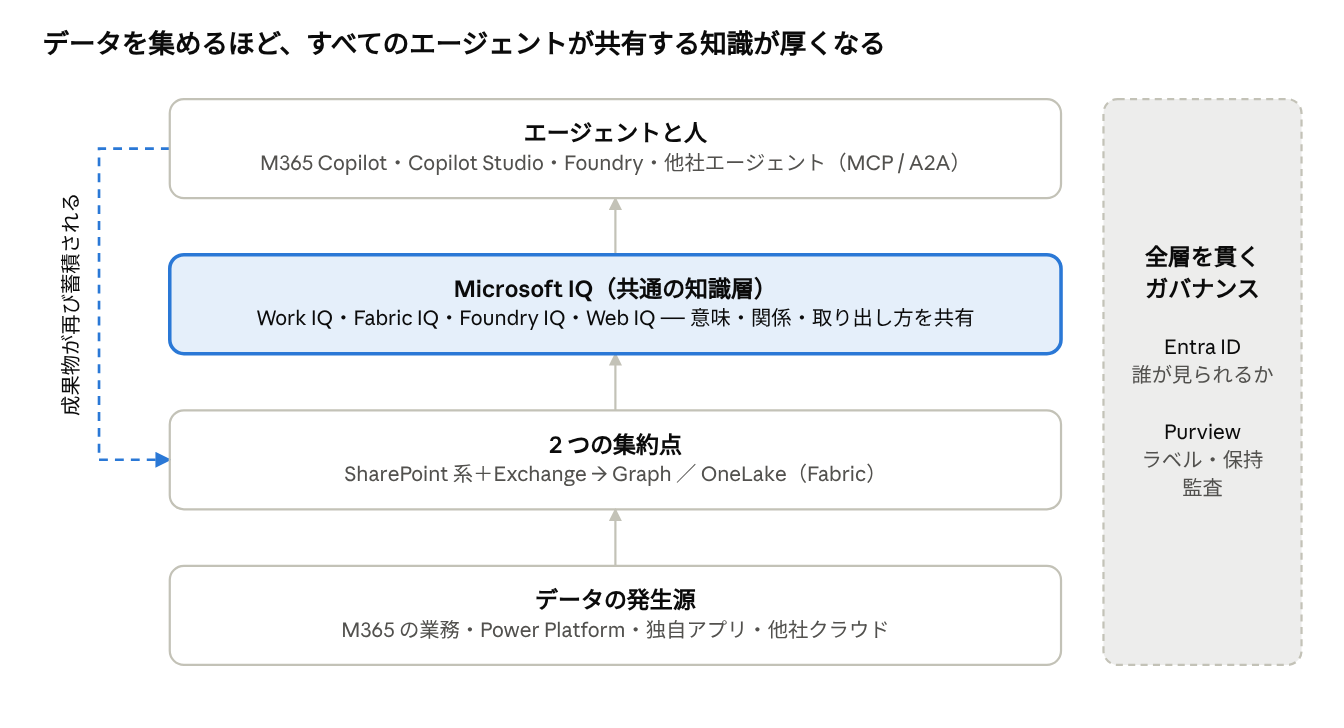
この構造には 3 つの特徴があります。
- 知識が循環する:エージェントが作った文書や会議メモは、再び SharePoint 系に保存され、次の質問の根拠になります。Work IQ もエージェントの途中成果をテナント内の SharePoint Embedded に保存する「Workspaces」を備えています。使うほど知識が厚くなる流れです。
- 非構造と構造化が出会う:これまで別世界だった「文書と会話」(Work IQ)と「数字と業務の実体」(Fabric IQ)を、一つの質問の中で組み合わせられます。例えば「先月売上が落ちた顧客と、その顧客との直近の会議内容」を一度に扱えます。
- 競争力は「データの整備度」に移る:AI モデルやエージェントの作り方は誰でも入手できます。差がつくのは、発生源が漏れなくつながっているか、業務の言葉が定義されているか、権限が正しいかという、下の 3 層の質です。
つまり「AI が豊かなデータを基盤に活用できる」状態とは、①発生源を漏れなく 2 つの集約点につなぎ、② IQ で意味を共有し、③権限を全層で一貫させた状態だと言えます。
出典
- Semantic indexing for Microsoft Copilot(Microsoft Learn)
- Teams meeting recording and transcript storage in OneDrive and SharePoint(Microsoft Learn)
- Overview of Loop storage(Microsoft Learn)
- Link your Dataverse environment to Microsoft Fabric(Microsoft Learn)
- Mirroring in Microsoft Fabric(Microsoft Learn)
- Microsoft 365 Copilot connectors overview(Microsoft Learn)
- Work IQ overview(Microsoft Learn)
- Announcing the new Work IQ APIs(Microsoft 365 Blog、2026年6月2日)
- What is Fabric IQ?(Microsoft Learn)
- What is Foundry IQ?(Microsoft Learn)
- The Microsoft IQ Family Explained(個人ブログ、2026年6月8日。Web IQ の状況はこちらに基づく)