第2回 検証環境を作る:Microsoft Foundryとローカル検索基盤
連載:Decision-1をRAGに組み込む:設計・検証・運用の実践・第2回 | 連載のまとめ
検索拡張生成(RAG)の比較実験を始めるとき、最初から本番と同じクラウド構成を作るべきでしょうか。今回の検証では、検索と評価のプログラムを手元で動かし、モデルの推論だけをMicrosoft Foundry(以下、Foundry)で行いました。回答品質の比較を先に進め、常時稼働するデータベースの費用を抑えるためです。
ここでは2026年10月16日から20日に実際に使った構成を説明します。構築記録に基づく解説であり、この執筆時に新しいAzure環境への再デプロイは行っていません。製品全体の現在の提供条件と、当時利用できた条件は区別します。[1]
1. 手元のランナーが検索・判定・生成をつなぐ
評価ランナーは、質問を読み、検索を行い、構成ごとの判定処理を実行して、回答とログを保存するPythonプログラムです。Foundryと検索データベースが直接通信する構成ではありません。両方を呼び出すのは、手元のランナーです。手元の実行環境にはWindows Subsystem for Linux 2(以下、WSL2)を使いました。
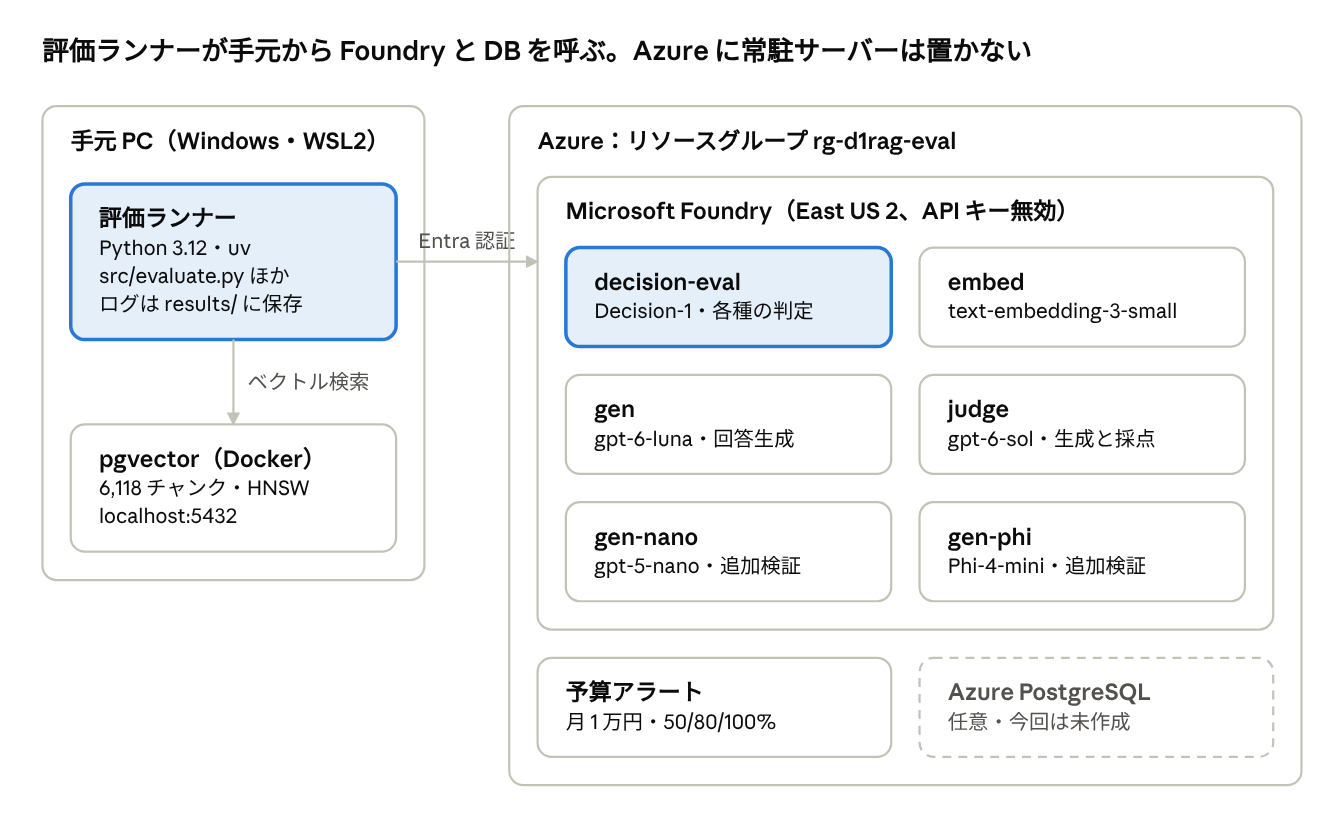
| 場所 | 部品 | 役割 |
|---|---|---|
| 手元のWindows/WSL2 | Python 3.12、uv | 実行環境と依存関係の管理 |
| 手元のDocker | PostgreSQL 16+pgvector 0.8.0 | チャンクと埋め込みの保存、ベクトル検索 |
| Foundry | text-embedding-3-small | 文書と質問の埋め込み |
| Foundry | Microsoft-Decision-1(以下、Decision-1) | 関連性・十分性・有用性の判定 |
| Foundry | gpt-6-luna | 主評価の回答生成 |
| Foundry | gpt-6-sol | 質問セット生成と回答の採点 |
追加評価では、回答生成をgpt-5-nanoとPhi-4-mini-instructに差し替えました。これらは検証で使ったモデル識別子です。モデルの性能順位を一般化するための網羅的な比較ではありません。
2. クラウドのデータベースを作らなかった理由
当初計画にはAzure Database for PostgreSQLを使う案がありましたが、実際にはローカルのデータベースで最後まで評価しました。今回まず確かめたかったのは、検索後の判定を変えたときの品質です。データベースの可用性やクラウド上の同時アクセス性能は、主な検証対象にしていません。
この選択により、クラウドの常時稼働費用を避け、検索結果を保存して再利用しやすくしました。ただし、クラウドのデータベースへ移しても速度や接続条件が同じになると実証したわけではありません。ネットワーク、索引設定、同時実行数が変われば、検索の所要時間も変わります。
さらに、ローカルに置いた文書も、選ばれたチャンクは判定や回答生成の入力としてFoundryへ送ります。「検索DBが手元にある」ことは、文書が外部へ送信されないことを意味しません。業務データで試す場合は、モデルへ渡す本文もデータの扱いの確認対象に含めます。
3. リージョンと認証は、実際の接続先で確認する
当時の確認では、Decision-1に使えた組み合わせに合わせ、FoundryをEast US 2、Decision-1のデプロイをDataZoneStandardで作成しました。リソースグループの場所はJapan Eastですが、それだけで推論処理が日本になるわけではありません。採用時には、各モデルのデプロイ種別と処理地域を別に確認します。[2]
認証にはMicrosoft Entra IDを使い、APIキーを無効にしました。検証の実行者へCognitive Services Userロールを割り当て、PythonのDefaultAzureCredentialでトークンを取得しています。これは今回の実施方式です。人が操作しない本番処理でも、同じように個人のログイン情報を使うことを勧めているわけではありません。
環境構築で時間がかかったのは、WindowsとWSL2でのAzure CLIと認証設定の使い分けでした。WSL2からWindows版Azure CLIを呼ぶ状態や、両者で認証キャッシュを共有する状態では、Pythonからのトークン取得がうまくいきませんでした。Linux版Azure CLIを使い、設定の保存先を分けて解消しています。[1]
疎通確認では、ログインの成功だけで終えず、埋め込み、判定、生成、採点、DB検索を小さな入力でそれぞれ呼びます。認証できても、対象のモデルを呼べる権限やクォータがそろっているとは限らないためです。
記録に沿って環境を準備する順序
準備する担当者には、Linux版Azure CLI、Bicep、Docker、uvと、Azureリソースの作成・ロール割り当てに必要な権限が必要です。モデル設定と利用可能なクォータを確認してから、作成内容を確認し、デプロイ、DB起動、疎通確認の順に進めます。
次は検証資料の手順を、確認したリポジトリのコミットに固定して整理した例です。WSL2などのLinux環境で実行します。本記事の執筆時には再実行していません。モデルの提供条件が変わっている場合は、設定を見直した別の実験として記録します。[1][2]
git clone https://github.com/yuyalush/d1-rag-eval
cd d1-rag-eval
git checkout 5e17bb4ad0b3965af37e2af28196f0bdfbf42b68
uv sync

export AZURE_CONFIG_DIR="$HOME/.azure-wsl"
az login --use-device-code
az account set --subscription <対象のサブスクリプションID>

infra/deploy.sh what-if
what-ifの結果とconfig/models.yamlを照合します。デプロイを実行すると、モデル利用に応じた課金や、ロール・予算設定の作成が発生します。対象と作成内容を確認した担当者が、次の手順を実行します。
infra/deploy.sh
docker compose up -d
uv run pytest
uv run python -m scripts.smoke_test
ローカルDBを使う場合は、生成された.envのDB接続情報をdocker-compose.ymlと合わせます。疎通確認で、五つの接続先への呼び出しが成功することを確かめてから、文書の取り込みへ進みます。デプロイやログインが成功しただけの状態で、大量の評価を開始しない順序にしています。
4. 設定とログを分けて、比較条件を残す
検証リポジトリでは、接続情報、モデル構成、実験条件を別のファイルに保存しています。[2]
| ファイル・保存先 | 残すもの | 分ける理由 |
|---|---|---|
.env |
エンドポイント、デプロイ名、DB接続情報 | 環境ごとに変わる接続先を管理する |
config/models.yaml |
モデル名、バージョン、デプロイ種別、容量、当時の単価 | 実行時のモデルと費用計算条件を追う |
config.yaml |
検索件数、判定文、しきい値、レート制限 | 構成間で何を変えたかを追う |
results/ |
検索結果、判定値、回答、時間、トークン数 | 集計から個別の失敗へ戻る |
1問の処理は「検索→判定→生成→保存」です。採点は回答の保存後に行います。回答生成と採点を分けることで、採点側でエラーが起きても、同じ回答を生成し直さずに済みます。
追加評価では、保存した検索結果と判定結果を使い、回答生成だけを差し替えました。この方法は検索条件をそろえるのに役立ちます。ただし、構成Eの関連性フィルターはgpt-6-lunaのままです。全処理を別モデルへ置き換えた実験とは区別します。
5. 再現にはコード以外の材料も必要になる
公開リポジトリにはレビュー済み質問セットがありますが、根拠のチャンクIDは今回取得した文書と分割結果に対応しています。Microsoft Learnを改めて取得すれば本文が更新されている可能性があり、同じIDでも同じ内容になる保証はありません。
元文書、data/chunks.jsonl、実行ログはGitの管理外です。質問ファイルだけを取得して、完全に同じ評価を再現できるとはいえません。元のチャンクを引き継ぐか、新しく取得・分割した文書に対して質問と根拠ラベルを作り直す必要があります。[1]
今回のようにまず品質を比較するなら、手元のランナーとDBは始めやすい構成です。本番への判断では、同時利用、処理地域、接続権限、障害時の再開、ログの保存先を、実際に運用する環境で改めて評価します。品質を測る環境と、本番の運用条件を確かめる環境には、それぞれの目的があります。
参考資料
資料の確認日:2026年10月23日。実施構成は2026年10月16日〜20日の記録です。
- Decision-1 RAG評価検証・資料リリース(筆者、2026年10月22日版)。「02_全作業記録」「03_計画からの変更点と理由」「05_検証手法」「07_作業レポート」と構成図を参照。
- 検証リポジトリ(筆者、確認時のコミット)。モデル設定とファイル構成を参照。現在の全リージョンの提供状況や本番構成の性能を示す資料ではありません。